webutvikling
Datamodellering - en introduksjon
Datamodellering er prosessen med å lage en strukturert representasjon av dataene som brukes i et system. Dette innebærer å definere hvordan dataene skal organiseres, hvilke typer data som skal lagres, og hvordan de ulike datatypene relaterer seg til hverandre. En god datamodell hjelper med å sikre at dataene er konsistente, lett tilgjengelige og enkle å vedlikeholde.
Eksempel på en enkel datamodell
La oss se på en samling med data om en person som et eksempel. Vi ønsker å lagre informasjon om navn, alder, adresse, postnummer, poststed, telefonnummer og e-postadresse. Vi kunne i utgangspunkt lagre all denne informasjonen i én tabell, og det ville sett slikt ut:
| Navn | Alder | Adresse | Postnummer | Poststed | Telefonnummer | E-postadresse |
|---|---|---|---|---|---|---|
| Ola Nordmann | 30 | Gateveien 1 | 0150 | Oslo | 12345678 | ola.nordmann@example.com |
| Kari Nordmann | 32 | Gateveien 1 | 0150 | Oslo | 12345678 | kari.nordmann@example.com |
| Per Hansen | 45 | Fjellveien 12 | 5003 | Bergen | 91234567 | per.hansen@example.com |
| Anne Larsen | 27 | Storgata 8 | 7010 | Trondheim | 90112233 | anne.larsen@example.com |
| Erik Johansen | 38 | Kirkegata 4 | 4008 | Stavanger | 95556677 | erik.johansen@example.com |
| Ingrid Berg | 52 | Skogveien 21 | 1613 | Fredrikstad | 41223344 | ingrid.berg@example.com |
| Lise Haugen | 29 | Ringveien 3 | 0150 | Oslo | 40556677 | lise.haugen@example.com |
| Thomas Solberg | 41 | Bygdøy Allé 15 | 0150 | Oslo | 47889900 | thomas.solberg@example.com |
| Mari Kristiansen | 35 | Nedre Bakke 6 | 5003 | Bergen | 92334455 | mari.kristiansen@example.com |
| Jonas Dahl | 24 | Øvre Torg 9 | 5003 | Bergen | 96778899 | jonas.dahl@example.com |
| Silje Pedersen | 48 | Elvegata 2 | 7010 | Trondheim | 93445566 | silje.pedersen@example.com |
| Magnus Eide | 33 | Hamnegata 14 | 7010 | Trondheim | 45667788 | magnus.eide@example.com |
Se på dataene, og vurder om det er noe som kan gjøre arbeidet tungvint.
Se svar
Legg merke til at postnummer og poststed gjentas for hver eneste person som bor på samme sted. Dette er ikke bare unødvendig skrivearbeid for den som registrerer nye personer, det er også en potensiell feilkilde: hva skjer om noen skriver «0150 Oslo» for én person og «0150 Oslio» (stavefeil) for en annen? Da har vi plutselig to ulike versjoner av det samme poststedet i databasen, uten at det finnes noe som fanger opp feilen.Å dele opp tabellen
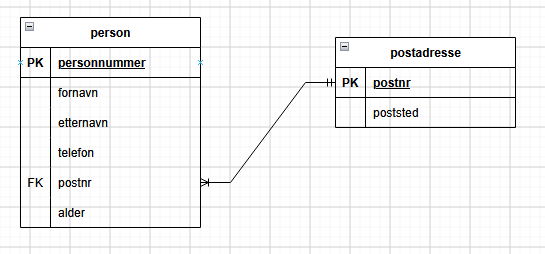
Løsningen på problemet er å dele opp den ene store tabellen i to mindre tabeller, slik at hver opplysning kun trenger å lagres ett sted:
- En tabell for poststed, med postnummer og tilhørende poststed. Her lagres hver postnummer/poststed-kombinasjon kun én gang.
- En tabell for personer, med de opplysningene som er unike for hver person (navn, alder, adresse, telefonnummer, e-postadresse), og en referanse til postnummeret personen bor på.
Denne referansen kalles en fremmednøkkel (foreign key), og peker til den kolonnen i poststed-tabellen som identifiserer hver rad entydig — den kalles en primærnøkkel (primary key). I dette tilfellet kan postnummeret fungere som primærnøkkel i poststed-tabellen, siden hvert postnummer kun skal forekomme én gang der.
Resultatet er at når vi registrerer en ny person, trenger vi bare å oppgi postnummeret. Poststedet slår vi opp automatisk via poststed-tabellen, og vi unngår både unødvendig skrivearbeid og faren for at samme poststed staves ulikt flere steder. Vi kan faktisk laste ned postnummer og poststed fra bring.no, og slippe å registrere det manuelt.
Nå skal vi tegne dette som en datamodell. Vi kaller dette for et entitets-relasjonsdiagram (ER-diagram). Vi kan for eksempel bruke draw.io, med de to tabellene og linjen som viser fremmednøkkel-relasjonen mellom dem.
Store tjenester er bygget opp av mange små tabeller
Prinsippet vi nettopp så — å dele opp én stor samling med data i flere mindre, sammenknyttede tabeller — er nøyaktig det som skjer bak kulissene til tjenestene dere bruker hver dag. Det dere opplever som én sammenhengende opplevelse i en app eller på et nettsted, er i virkeligheten satt sammen av data hentet fra mange ulike tabeller i en database.
I dette avsnittet skal vi se på noen tjenester dere kjenner godt, tenke gjennom hva de faktisk må lagre av informasjon, og hvordan den informasjonen med fordel kan deles opp.
Eksempel 1: Musikktjeneste (som Spotify)
Når du åpner en musikktjeneste som Spotify, YouTube Music, Apple Music eller lignende, hva tenker du er nødvendig for at en slik tjeneste skal fungere? Hva må den lagre av informasjon?
Tenk gjennom: Hvis alt dette ble lagret i én stor tabell (én rad per sang du har lyttet til, med ditt brukernavn, sanginfo, albuminfo og artistinfo i samme rad), hva ville blitt gjentatt unødvendig mange ganger? Hvordan ville du delt opp dette i flere tabeller, og hvilke fremmednøkler trengs for å knytte dem sammen?
Se forslag til løsning
Eksempel på informasjon som må lagres: - Hvem du er (brukernavn, e-post, passord, abonnementstype, ...) - Hvilke spillelister du har laget, og hva de heter - Hvilke sanger som ligger i hver spilleliste - Informasjon om hver sang (tittel, lengde, hvilket album den tilhører) - Informasjon om hvert album (tittel, utgivelsesår, hvilken artist det tilhører) - Informasjon om hver artist (navn, sjanger, ...) - ... Et vanlig forslag er å dele opp i egne tabeller for **Bruker**, **Spilleliste**, **Sang**, **Album** og **Artist**: - **Artist**-tabellen lagrer hver artist kun én gang (navn, sjanger). - **Album**-tabellen har en fremmednøkkel til artisten som laget albumet, slik at albumtittel og utgivelsesår ikke trenger å gjentas for hver sang. - **Sang**-tabellen har en fremmednøkkel til albumet sangen tilhører. - **Bruker**-tabellen lagrer kontoinformasjon uavhengig av musikk. - Fordi én bruker kan ha mange spillelister, og én spilleliste kan inneholde mange sanger (og samme sang kan ligge i mange spillelister), trengs det gjerne en egen **Spilleliste_sang**-tabell som bare kobler sammen en spilleliste-ID og en sang-ID.Eksempel 2: Nettbutikk
Når du handler i en nettbutikk, legger du varer i handlekurven og fullfører en bestilling. Hva tenker du er nødvendig for at en slik tjeneste skal fungere? Hva må den lagre av informasjon?
Se forslag til løsning
Eksempel på informasjon som må lagres: - Informasjon om deg som kunde (navn, adresse, e-post) - Informasjon om hver vare som selges (navn, pris, beskrivelse, lagerstatus) - Hvilken bestilling du har gjort, og når - Hvilke varer, og hvor mange av hver, som inngår i akkurat den bestillingen - Leveringsstatus for bestillingen **Tenk gjennom:** Én bestilling inneholder ofte flere ulike varer, og samme vare kan bli kjøpt av mange forskjellige kunder i mange forskjellige bestillinger. Hvordan ville du organisert dette i tabeller, slik at verken kundeinformasjon eller vareinformasjon gjentas unødvendig? Et vanlig forslag er tabellene **Kunde**, **Vare**, **Bestilling** og **Bestillingslinje**: - **Kunde**-tabellen lagrer hver kunde kun én gang. - **Vare**-tabellen lagrer hver vare kun én gang, uavhengig av hvor mange som har kjøpt den. - **Bestilling**-tabellen har én rad per bestilling, med en fremmednøkkel til hvilken kunde som bestilte, og en dato. - **Bestillingslinje**-tabellen har én rad per vare i en bestilling, med fremmednøkkel til både bestillingen og varen, samt antall. Dette gjør at én bestilling can inneholde flere varer, uten at kunde- eller vareinformasjonen må skrives inn på nytt. - ...Eksempel 3: Sosiale medier
På et sosialt medium ser du et innhold bestående av innlegg, bilder, kommentarer og likerklikk fra andre brukere. Hva tenker du er nødvendig for at en slik tjeneste skal fungere? Hva må den lagre av informasjon?
Se forslag til løsning
Eksempel på informasjon som må lagres: - Informasjon om hver bruker (brukernavn, profilbilde, bio, ...) - Hvert innlegg som publiseres, og hvem som publiserte det - Hver kommentar til et innlegg, og hvem som skrev den - Hvem som har likt hvilke innlegg - Hvem som følger hvem **Tenk gjennom:** Legg spesielt merke til «hvem følger hvem» og «hvem har likt hva» — begge deler kobler sammen to brukere, eller en bruker og et innlegg, uten at det egentlig er noen ny «ting» som blir laget. Hvordan ville du løst dette i tabeller? Et vanlig forslag er tabellene **Bruker**, **Innlegg**, **Kommentar**, **Følger** og **Liker**: - **Bruker**-tabellen lagrer hver bruker kun én gang. - **Innlegg**-tabellen har én rad per innlegg, med fremmednøkkel til hvilken bruker som publiserte det. - **Kommentar**-tabellen har én rad per kommentar, med fremmednøkkel til både innlegget og brukeren som skrev kommentaren. - **Følger**-tabellen kobler sammen to brukere: en fremmednøkkel til brukeren som følger, og en fremmednøkkel til brukeren som blir fulgt. - **Liker**-tabellen kobler sammen en bruker og et innlegg: en fremmednøkkel til brukeren, og en fremmednøkkel til innlegget som ble likt. Legg merke til at både «Følger» og «Liker» ikke har noen egen naturlig informasjon utover selve koblingen — de eksisterer kun for å knytte sammen rader i andre tabeller. Dette er et svært vanlig mønster når man modellerer relasjoner mellom mange-til-mange (f.eks. mange brukere kan følge mange andre brukere). Dette er mer komplisert, og noe vi først forfølger senere i kurset.Oppsummering
Det disse tre eksemplene har til felles, er at en stor tjeneste sjelden (eller aldri) lagrer alt i én tabell. I stedet identifiserer man de ulike entitetene i systemet (bruker, vare, innlegg, sang, osv.), lager én tabell per entitet, og bruker fremmednøkler for å knytte dem sammen der det er en sammenheng. Dette er selve kjernen i datamodellering: å finne ut hvilke «ting» systemet handler om, og hvordan disse tingene henger sammen.
Oppgaver
Se på ulike tjenester du bruker, og tenk gjennom hva de må lagre av informasjon. Hvordan ville du organisert dette i tabeller, slik at informasjonen ikke gjentas unødvendig? Hvilke fremmednøkler trengs for å knytte tabellene sammen?
Eksempelvis:
- IMDB (https://www.imdb.com/) — hva må de lagre om filmer, skuespillere, regissører, anmeldelser, brukere, osv.?
- Adams Matkasse (https://www.adamsmatkasse.no/) — hva må de lagre om kunder, bestillinger, oppskrifter, ingredienser, osv.?
- Vy (https://www.vy.no/) — hva må de lagre om kunder, billetter, togavganger, stasjoner, osv.?
- Finn.no (https://www.finn.no/) — hva må de lagre om brukere, annonser, bilder, meldinger, osv.?
- Finn andre tjenester du bruker, og tenk gjennom hvordan de kan ha organisert dataene sine i tabeller.